RAG vs Fine-tuning: quando usar cada um no negócio (sem jogar dinheiro fora)
- RAG busca informação em fontes externas (seus arquivos/sistemas) na hora da resposta; fine-tuning ajusta o modelo para um padrão.
- RAG é mais rápido para manter atualizado; fine-tuning tende a ser mais trabalhoso para atualizar e governar.
- RAG depende de boa indexação/embeddings e qualidade documental; fine-tuning depende de dataset limpo e critérios claros.
- Para reduzir risco de resposta “inventada”, RAG com citações e regras de não responder costuma ser o caminho mais direto.
O que muda de verdade entre RAG e fine-tuning
Na prática, a pergunta não é “qual é melhor?”, e sim: você está tentando resolver falta de informação ou falta de padrão?
RAG (Retrieval-Augmented Generation) é como dar ao modelo uma biblioteca da empresa e obrigá-lo a consultar antes de responder. Ele não “aprende” permanentemente o conteúdo; ele recupera trechos relevantes e usa isso como contexto.
Fine-tuning é mais parecido com treinar um colaborador: você mostra exemplos do jeito certo de responder e ele internaliza esse padrão. Funciona bem para tom de voz, formatos, classificações e respostas consistentes — mas não é a melhor ferramenta para ficar “decorando” informação que muda toda semana.
Quadro rápido de decisão (use como checklist)
Se você só tiver 2 minutos, olhe a tabela e marque onde dói mais hoje.
| Critério | RAG (buscar documentos) | Fine-tuning (ajustar modelo) |
|---|---|---|
| Quando brilha | Respostas baseadas em políticas, manuais, contratos, FAQs, catálogo, histórico permitido | Tom de voz consistente, formato fixo, classificação/extração padronizada, comportamento previsível |
| Atualização do conhecimento | Troca o documento e reindexa; o modelo já passa a “ver” a versão nova | Precisa novo ciclo de treino para incorporar mudanças relevantes no padrão |
| Dependência principal | Qualidade dos documentos + busca (indexação/embeddings) + regras de citação | Dataset de exemplos (input→output) bem curado e representativo |
| Risco típico | Buscar trecho errado ou incompleto e responder com confiança | Aprender viés do dataset, “endurecer” respostas ruins e ficar difícil de reverter |
| Privacidade e LGPD | Exige governança forte do que entra no índice e do que pode ser recuperado | Exige cuidado redobrado: exemplos de treino não podem carregar dados pessoais/segredos |
| Custo/complexidade (em geral) | Começa menor, mas cresce com volume, conectores, qualidade do pipeline | Pode ficar caro e demorado se o dataset for grande e a iteração for frequente |
Cenários comuns no Brasil (e o que eu escolheria primeiro)
Alguns padrões se repetem em PMEs e times corporativos. A escolha abaixo é mais prática do que “acadêmica”.
- Atendimento com base em políticas, prazos, cobertura, regras: comece com RAG (com citações e trilhas de auditoria).
- Geração de propostas e relatórios no padrão da empresa: RAG para fatos (portfólio, cases, condições) + prompt/template; fine-tuning só se ainda variar demais.
- Classificar e triar solicitações (e-mail/tickets) em categorias fixas: fine-tuning ou modelos de classificação; RAG só se a categoria depender de regra em documento.
- Agente interno para consultar procedimentos (SOP/POP), onboarding e dúvidas: RAG quase sempre resolve melhor e é mais fácil de manter.
- Copys e textos “com a voz da marca” em alto volume: fine-tuning pode ajudar, mas muitas vezes um bom system prompt + exemplos (few-shot) já entrega 80%.
Como evitar os dois erros caros: RAG mal feito e fine-tuning cedo demais
Erro 1: achar que RAG é só “jogar PDFs num lugar”. Se o documento é confuso, desatualizado ou contraditório, o modelo vai reproduzir isso. O ganho vem quando você trata documentação como produto: versão, dono, revisão e linguagem clara.
Erro 2: partir para fine-tuning para “corrigir alucinação”. Fine-tuning não é antídoto para falta de fontes. Se o modelo não tem acesso confiável ao dado, ele vai continuar improvisando — só que agora com mais convicção e um estilo mais consistente.
O caminho conservador (que costuma dar menos retrabalho): padronize prompts e regras → construa RAG com boas fontes e citações → só então avalie fine-tuning para padronização fina.
Passo a passo de escolha (decisão em 15 minutos com o time)
Faça esta conversa rápida com alguém de operação (quem sofre o problema) e alguém de dados/tech.
- Liste 10 perguntas reais que a IA precisa responder (copie de tickets/e-mails).
- Para cada pergunta, marque: a resposta depende de um documento específico (sim/não)?
- Se “sim” em mais da metade: RAG é prioridade.
- Agora pegue 10 respostas “do jeito certo” (modelos aprovados). Se você não consegue coletar exemplos bons e consistentes, fine-tuning ainda não é hora.
- Defina a régua de qualidade: precisa citar fonte? precisa dizer “não sei”? precisa escalar para humano?
- Teste com um piloto pequeno e meça por revisão humana (não por “achismo”).
Perguntas frequentes
RAG substitui fine-tuning?
Dá para fazer RAG sem banco vetorial?
Fine-tuning serve para colocar conhecimento interno dentro do modelo?
O que reduz mais alucinação: RAG ou fine-tuning?
Leia também
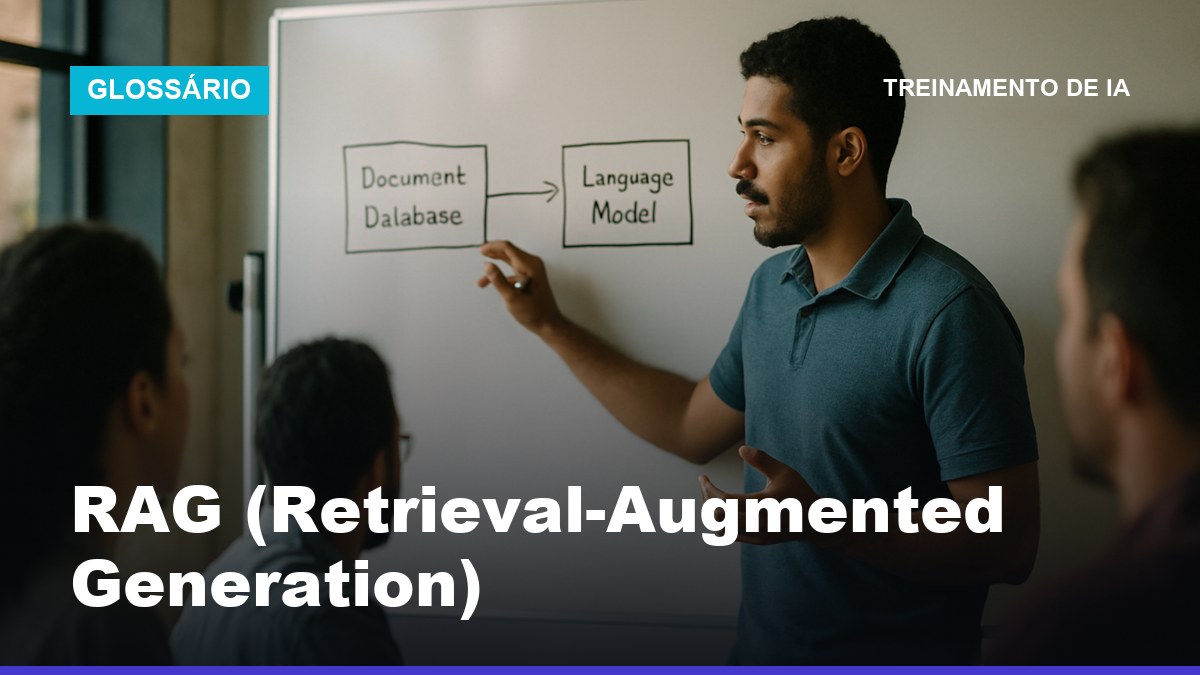
RAG (Retrieval-Augmented Generation)
RAG é a técnica que permite a modelos de IA buscar informações em documentos externos antes de responder. Entenda como funciona e por que elimina alucinações.
Ler →
Fine-Tuning
Fine-tuning é o processo de ajustar um modelo de IA já treinado com dados específicos do seu negócio. Entenda como funciona, quando usar e quando o prompt engineering resolve melhor.
Ler →
Como escolher um banco de dados vetorial para RAG (sem cair em modismo)
Guia direto para escolher um banco de dados vetorial para RAG: critérios, perguntas certas, tabela de decisão, riscos de privacidade e como testar antes de fechar contrato.
Ler →
Como escolher o modelo de IA certo por tarefa (qualidade, custo e privacidade)
Guia prático para escolher o modelo de IA ideal por tarefa (texto, planilha, código, imagem), equilibrando qualidade, custo, velocidade e privacidade sem cair em modismos.
Ler →